
Datenintegration aus Unternehmenssystemen
Die Zahlen aus Produktion, Lager und Buchhaltung passen nicht zusammen, und der Bericht für die Geschäftsleitung entsteht von Hand? Wir verbinden Daten aus Systemen verschiedener Anbieter dort, wo sie bereits lesbar sind, zu einem Ganzen, dem man vertrauen kann.
Was Sie mit dieser Leistung bekommen
Neun Themen, nach denen Sie uns am häufigsten fragen. Klappen Sie auf, was Sie interessiert – Details und Antworten finden Sie darin.
Ein Datenmodell
Zehn Quellen überführen wir in ein Modell, mit dem sich arbeiten lässt.
Jedes System spricht anders: anderes Format, andere Namen für dasselbe, andere Struktur. Die Abbildung auf ein Modell ist der Großteil der Arbeit – und ohne sie lässt sich nichts Weiteres bauen.
- Was, wenn eine Quelle keine API hat?
- Wir verarbeiten auch Exporte, Datenbank-Dumps, E-Mail-Anhänge und im Extremfall das Auslesen von Websites oder Bildern – etwa vom Foto eines Messgeräts, eines Bildschirms oder eines gescannten Dokuments, was heute recht zuverlässig funktioniert. Entscheidend ist, dass der Zugriff stabil und legal ist, nicht auf welchem Weg er erfolgt.
- Können Sie Daten direkt aus Maschinen auslesen?
- Wir arbeiten mit Daten, die bereits irgendwo lesbar sind – in einer Datenbank, einem Export oder der API des Systems, das die Maschinen steuert. Die direkte Anbindung an die Maschinensteuerung ist Sache des Maschinenlieferanten oder seines Integrators; mit ihm vereinbaren wir die Übergabe der Daten.
Abgleich von Datensätzen
Dieselbe Entität erkennen wir auch unter anderer ID und anders geschriebener Adresse.
Wir gleichen per Regeln und Ähnlichkeitsvergleich ab. Grenzfälle lassen wir von einem Menschen bestätigen, damit wir nicht blind zwei Kunden zu einem zusammenführen.
Qualitätskontrollen und Herkunft
Wenn eine Quelle plötzlich Unsinn liefert, erfahren Sie es von uns.
Ein Export bekommt eine neue Spalte, eine API ändert ihre Struktur, eine Website antwortet nicht mehr. Validierungen am Ein- und Ausgang erfassen das, bevor eine Ausgabe kaputtgeht, auf die sich jemand verlässt.
Zu jedem Wert führen wir, woher er stammt, wann er geladen und wie er berechnet wurde. Ohne das wird den Daten im Unternehmen niemand vertrauen – und das zu Recht.
Schluss mit dem Abtippen
Die Daten wandern geplant und wiederholbar zwischen den Systemen, ohne dass ein Mensch daneben sitzt.
Das ist der häufigste Grund, warum wir die Verarbeitung überhaupt angehen. Das Ergebnis erhalten Sie als API, als Export in weitere Systeme oder als Übersichten, die sich selbst erzeugen.
- Müssen wir dafür unsere Systeme ändern?
- Nein. Ihre Systeme bleiben, wie sie sind; wir nehmen die Daten dort, wo sie bereits lesbar sind. Wenn Sie auch ein Werkzeug wollen, in dem gearbeitet wird – Erfassung, Freigaben oder Formulare –, ist das ein maßgeschneidertes Informationssystem, und wir binden es an die vereinheitlichten Daten an.
- Wer sollte das bei uns verantworten?
- Es genügen eine Person, die weiß, woher Ihre Daten kommen, und eine, die entscheidet, was sie darin sehen will. Den technischen Teil, die Abstimmung mit den Systemanbietern über Zugänge und den Betrieb übernehmen wir.
Millionen Datensätze
Verarbeitung in Batches, mit einem Protokoll jedes Laufs.
Ändert sich eine Regel, verarbeiten wir die Historie neu – ohne manuelles Nachsuchen. Wir setzen auf bewährtes Open Source, nicht auf eine Blackbox.
- Welche Technologien verwenden Sie?
- PostgreSQL, Node.js, Python, Elasticsearch und Redis. Die Planung der Läufe richtet sich nach der Umgebung – von Cron bis Airflow.
Grundlage für KI und Suche
Vereinheitlichte Daten sind die Voraussetzung dafür, dass Modell oder Suche Sinnvolles liefern.
Ohne sie rät das Modell selbstbewusst, und die Suche liefert drei Versionen desselben. Deshalb ist die Datenverarbeitung oft der erste Schritt vor einer KI-Integration.
KI-Integration- Kann man die Daten dann in ganz normalen Sätzen befragen?
- Ja. Auf den vereinheitlichten Daten bauen wir einen Assistenten, der mit Verweis auf die Quelle antwortet, oder eine Suche, die auch das findet, was Sie nicht genau benennen können. Das ist die häufigste Fortsetzung.
Wie wir es einführen
Eine Frage und eine Ausgabe. Sobald das funktioniert, kommen weitere hinzu.
-
Analyse der Quellen Wir wählen eine Frage, auf die heute niemand schnell eine Antwort hat – etwa einen Bericht, der von Hand entsteht – und gehen die Quellen durch, aus denen sie sich beantworten lässt. Daraus ergeben sich Datenmodell, Umfang und Preis.
-
Pipeline und Kontrollen Erfassung, Bereinigung, Abgleich und Validierung – automatisch, wiederholbar und mit einem Protokoll jedes Laufs.
-
Betrieb und Weiterentwicklung Monitoring der Läufe, Meldung von Abweichungen und bei Bedarf weitere Quellen oder Ausgaben.
Was es kostet
Den Preis nennen wir nach der Analyse der Quellen: wie viele es sind, in welcher Qualität und wie oft sie sich ändern.
An der ersten Frage und der ersten Ausgabe sieht man innerhalb weniger Wochen, wie sich mit den Daten arbeiten lässt, und Sie entscheiden, ob es weitergeht. Weitere Quellen werden dann nach tatsächlicher Erfahrung bepreist, nicht nach einer Schätzung.
Betrieb und weitere Quellen
Monitoring der Läufe, Meldung von Abweichungen und Kapazität für weitere Quellen.
Eine Verarbeitung, die täglich läuft, braucht jemanden, der sie überwacht. Das können wir sein – Verfahren und Regeln sind aber beschrieben und laufen bei Ihnen.
Betrieb, Support und WeiterentwicklungDaten, die wir verarbeiten
Erfassung aus Dutzenden Quellen, Bereinigung und Vereinheitlichung – bei einem Teil der Projekte läuft das täglich.
Alle unsere Referenzen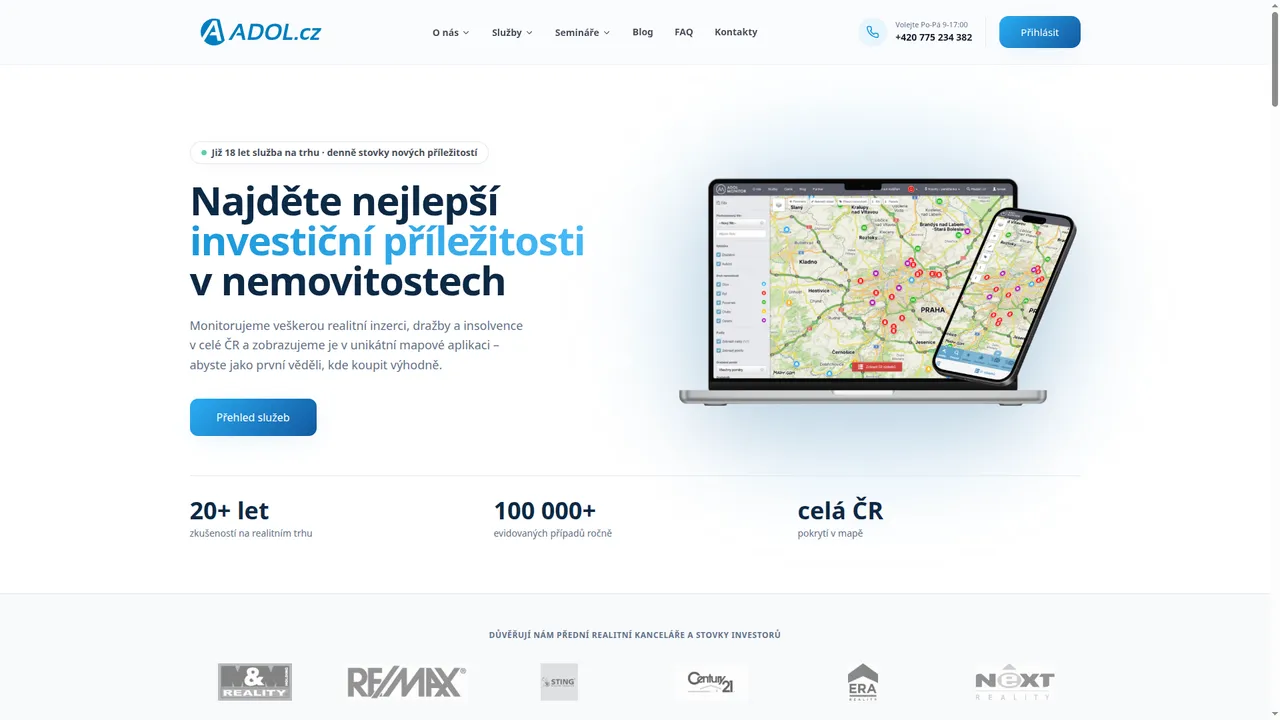
Adol Monitor
Monitoring von Versteigerungen und Zwangsverkäufen von Immobilien – automatische Datenerfassung aus Dutzenden Quellen, Zusammenführung der Daten und ein Benachrichtigungsdienst für Kunden.
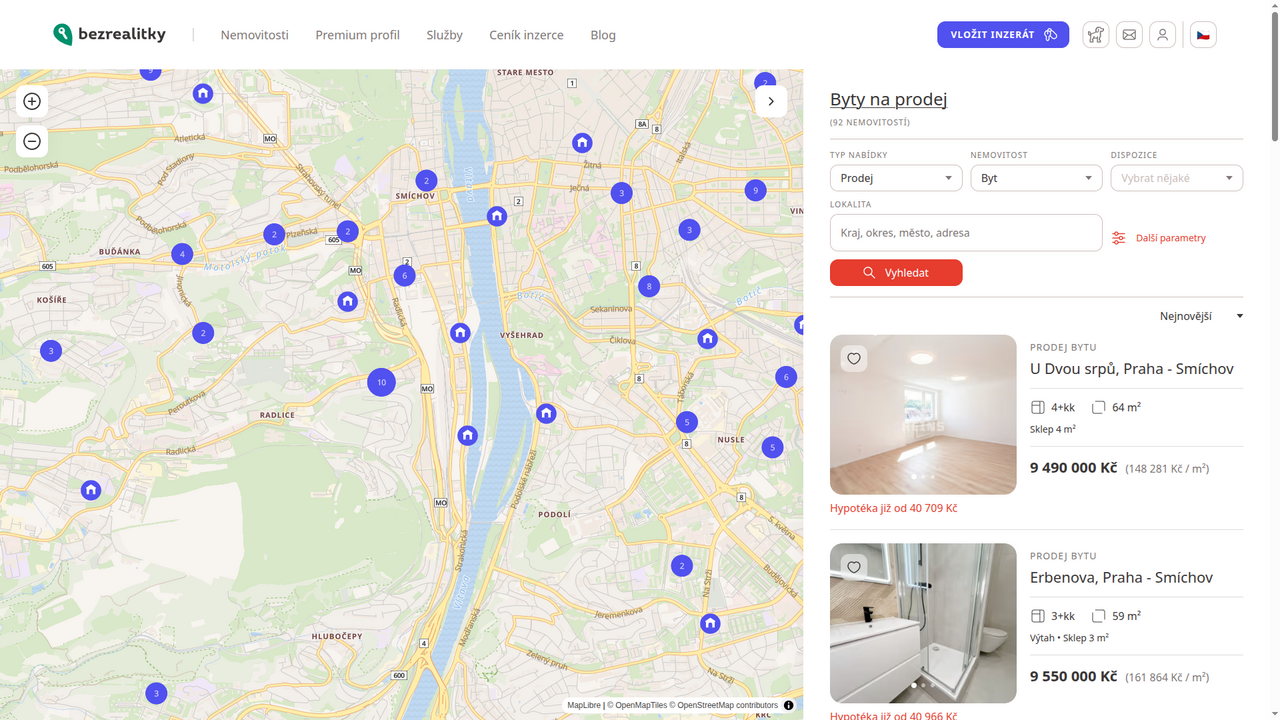
Bezrealitky
Das erfolgreichste Immobilienportal für Verkauf und Vermietung direkt vom Eigentümer. Wir entwickeln es seit 2007 ohne Unterbrechung und halten es bei Zehntausenden Besuchern täglich am Laufen.
Warum Sie uns wählen sollten
Datenverarbeitung ist unser Kerngebiet, kein Nebenprodukt. Bei einem Teil der Projekte läuft sie täglich.
- Seit 2011 verarbeitet Adol Monitor bei uns jeden Tag Immobilien, Versteigerungen, Zwangsvollstreckungen und Insolvenzen aus Dutzenden Quellen – Auktionsportalen, Registern, Gerichtsvollzieherämtern und Immobilienportalen.
- Für Grainterminal, heute das Handelsmodul von CleverFarm, ermitteln wir aus Börsenkursen, Wechselkursen und Angaben von Händlern, Logistikern und Maklern die besten Rohstoffpreise für jede Region.
- Wir wissen, wo Daten brechen: eine Quelle ohne API, Anhänge in E-Mails, dasselbe unter einer anderen Kennung, Strukturänderungen ohne Ankündigung.
- Wir beginnen nicht mit einer großen Plattform, sondern mit einer Frage und einer Ausgabe, an der sofort sichtbar ist, ob sich mit den Daten arbeiten lässt.
Wir sehen uns Ihre Datenquellen an
Schreiben Sie uns, woher Sie Ihre Daten beziehen und was Sie aus ihnen herausholen müssen.