
Integrace dat z firemních systémů
Čísla z výroby, skladu a účetnictví nesedí a přehled pro vedení se skládá ručně? Data ze systémů od různých dodavatelů propojíme tam, kde už jsou čitelná, do jednoho celku, kterému jde věřit.
Co v rámci služby dostanete
Devět témat, na která se ptáte nejčastěji. Rozklikněte, co vás zajímá – podrobnosti i odpovědi jsou uvnitř.
Jeden datový model
Deset zdrojů převedeme do jednoho modelu, se kterým se dá pracovat.
Každý systém mluví jinak: jiný formát, jiné názvy pro totéž, jiná struktura. Mapování do jednoho modelu je většina práce – a bez něj se nedá postavit nic dalšího.
- Co když zdroj nemá API?
- Řešíme i exporty, databázové dumpy, přílohy e-mailů a v krajním případě čtení z webu nebo z obrazu – třeba z fotky měřidla, obrazovky nebo naskenovaného dokumentu, což dnes jde rozumně spolehlivě. Důležitá je stabilita a legálnost přístupu, ne jeho způsob.
- Umíte data číst přímo ze strojů?
- Pracujeme s daty, která už někde čitelná jsou – v databázi, exportu nebo API systému, který stroje obsluhuje. Napojení přímo na řízení strojů je práce pro dodavatele stroje nebo jeho integrátora; s ním se domluvíme na předávání dat.
Párování záznamů
Tentýž subjekt poznáme i pod jiným ID a jiným zápisem adresy.
Párujeme pravidly i porovnáním podobnosti. Hraniční případy necháváme potvrdit člověkem, takže vám nesloučíme dva zákazníky do jednoho naslepo.
Kontroly kvality a původ
Když zdroj začne dodávat nesmysly, dozvíte se to od nás.
Export dostane nový sloupec, API změní strukturu, web přestane odpovídat. Validace na vstupu i výstupu to zachytí dřív, než se rozbije výstup, na který se někdo spoléhá.
Ke každému údaji vedeme, odkud je, kdy se načetl a jak se počítal. Bez toho datům nikdo ve firmě nebude věřit – a právem.
Konec ručního přepisování
Data mezi systémy putují naplánovaně a opakovatelně, bez člověka u toho.
Tohle je nejčastější důvod, proč se do zpracování vůbec pouštíme. Výsledek dostanete jako API, export do dalších systémů nebo přehledy, které se generují samy.
- Musíme kvůli tomu měnit systémy?
- Ne. Systémy zůstávají, jak jsou, data z nich bereme tam, kde už jsou čitelná. Když budete chtít i nástroj, ve kterém se pracuje – evidenci, schvalování nebo formuláře –, je to informační systém na míru a na sjednocená data ho napojíme.
- Kdo to u nás má mít na starosti?
- Stačí jeden člověk, který ví, odkud data berete, a jeden, kdo rozhodne, co z nich chce vidět. Technickou část, jednání s dodavateli systémů o přístupech i provoz zajistíme my.
Miliony záznamů
Zpracování po dávkách, se záznamem o každém běhu.
Když se pravidlo změní, pustíme historii znovu – bez ručního dohledávání. Stavíme na prověřeném open source, ne na černé skříňce.
- Jaké technologie používáte?
- PostgreSQL, Node.js, Python, Elasticsearch a Redis. Plánování běhů podle prostředí – od cronu po Airflow.
Základ pro AI a vyhledávání
Sjednocená data jsou podmínka, aby model nebo vyhledávání dávaly smysl.
Bez nich model sebevědomě hádá a vyhledávání vrací tři verze téhož. Proto bývá zpracování dat první krok před integrací AI.
Implementace AI- Půjde se pak na data ptát běžnou větou?
- Ano. Nad sjednocenými daty postavíme asistenta, který odpoví s odkazem na zdroj, nebo vyhledávání, které najde i to, co neumíte přesně pojmenovat. Je to nejčastější pokračování.
Jak to zavádíme
Jedna otázka a jeden výstup. Až funguje, přidávají se další.
-
Analýza zdrojů Vybereme jednu otázku, na kterou dnes nikdo nemá rychlou odpověď – třeba přehled, který se skládá ručně – a projdeme zdroje, ze kterých ji poskládáme. Z toho vyjde datový model, rozsah a cena.
-
Pipeline a kontroly Sběr, čištění, párování a validace – automaticky, opakovatelně a se záznamem o každém běhu.
-
Provoz a rozvoj Monitoring běhů, hlášení odchylek a přidávání dalších zdrojů nebo výstupů podle potřeby.
Kolik to stojí
Cenu dáváme po analýze zdrojů: kolik jich je, v jaké kvalitě a jak často se mění.
Na první otázce a prvním výstupu je v řádu týdnů vidět, jak se s daty pracuje, a vy rozhodnete, jestli pokračovat. Další zdroje se pak oceňují podle skutečnosti, ne podle odhadu.
Provoz a další zdroje
Monitoring běhů, hlášení odchylek a kapacita na další zdroje.
Zpracování, které běží každý den, potřebuje někoho, kdo ho hlídá. Můžeme to být my – postup i pravidla jsou ale popsané a běží u vás.
Provoz, podpora a rozvojData, která zpracováváme
Sběr z desítek zdrojů, čištění a sjednocení – u části projektů to běží každý den.
Všechny naše reference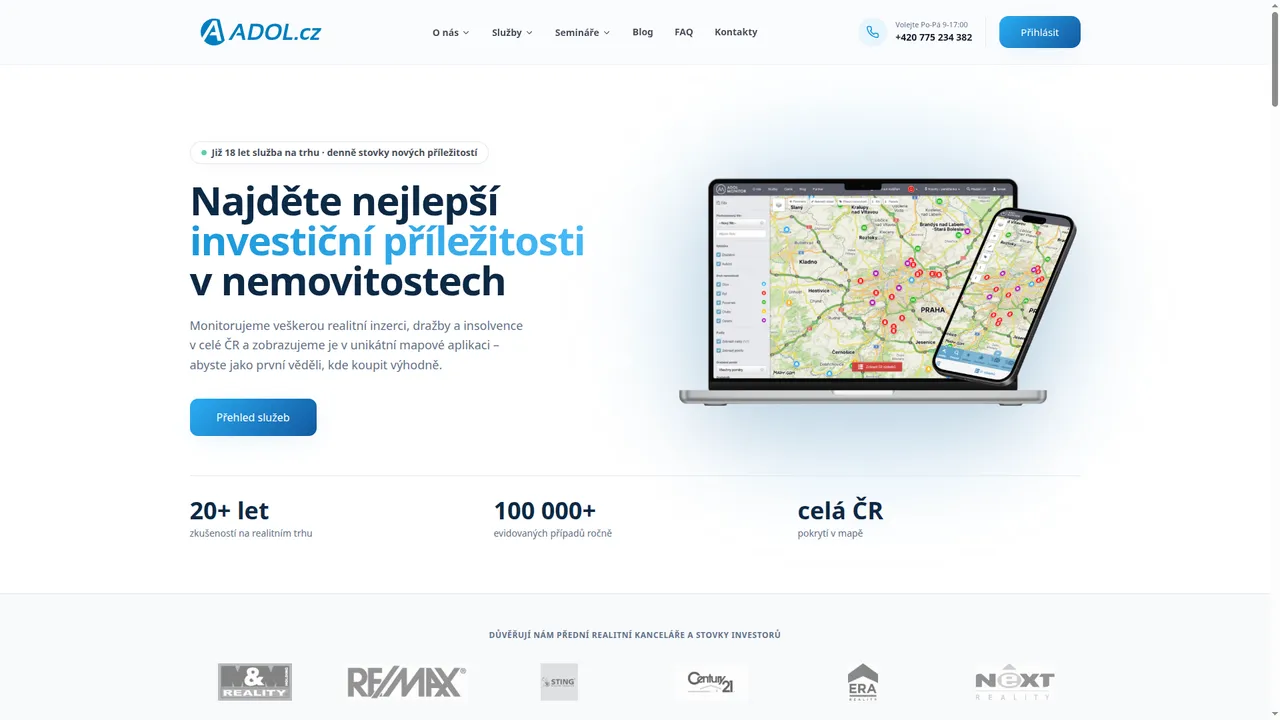
Adol Monitor
Monitoring dražeb a exekučních prodejů nemovitostí – automatický sběr dat z desítek zdrojů, jejich sjednocení a hlídací pes pro klienty.
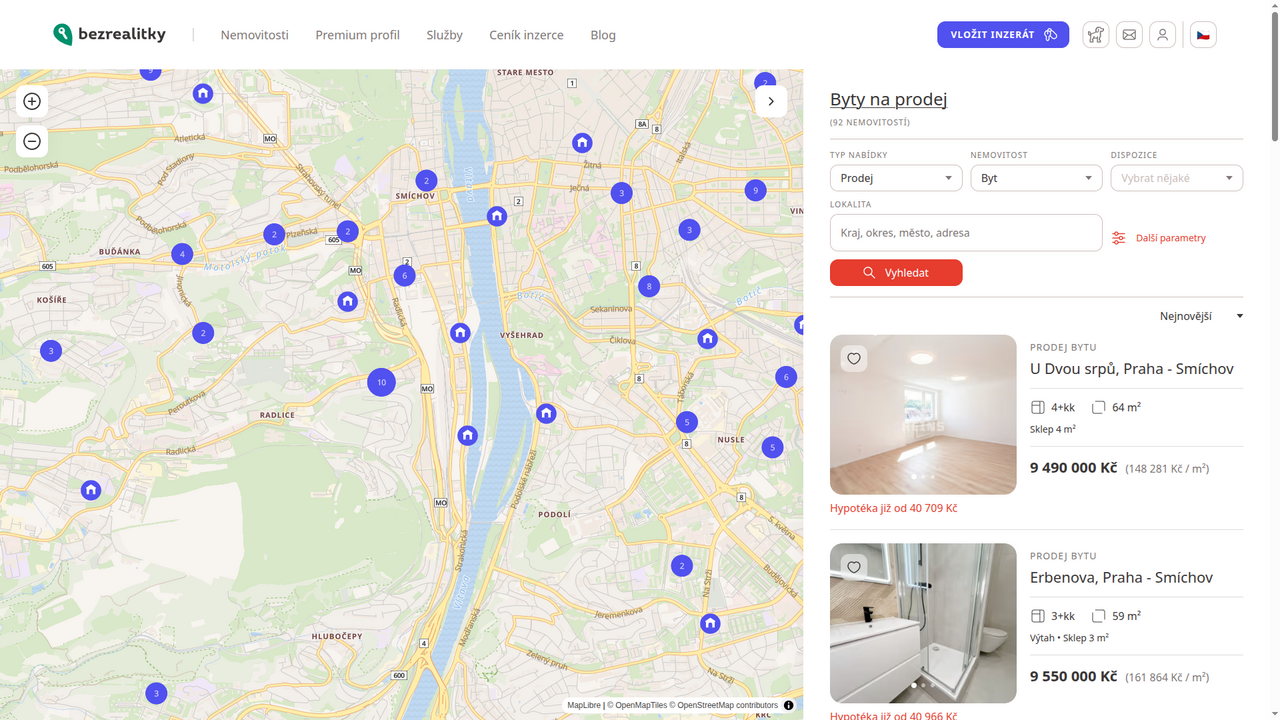
Bezrealitky
Nejúspěšnější realitní portál pro prodej a pronájem nemovitostí přímo od majitelů. Vyvíjíme ho nepřetržitě od roku 2007 a držíme v provozu při zátěži desítek tisíc lidí denně.
Proč to dát nám
Zpracování dat je náš hlavní obor, ne vedlejší produkt. U části projektů běží každý den.
- Adol Monitor u nás každý den od roku 2011 zpracovává nemovitosti, dražby, exekuce i insolvence z desítek zdrojů – dražebních portálů, rejstříků, exekutorských úřadů i realitních serverů.
- Pro Grainterminal, dnes obchodní modul CleverFarm, skládáme z burzovních cen, kurzů a podkladů od obchodníků, logistiků a brokerů nejvhodnější ceny komodit pro jednotlivé regiony.
- Víme, kde se data lámou: zdroj bez API, přílohy v e-mailu, totéž pod jiným identifikátorem, změna struktury bez ohlášení.
- Nezačínáme velkou platformou, ale jednou otázkou a jedním výstupem, na kterém je hned vidět, jestli se s daty dá pracovat.
Projdeme vaše zdroje dat
Napište nám, odkud data berete a co z nich potřebujete dostat.