
EMLAP
EMLAP (Early Modern Latin Alchemical Prints) ist ein Korpus lateinischer alchemistischer Drucke des Philosophischen Instituts der Tschechischen Akademie der Wissenschaften. Die Daten liefern das Institut und das CCS Lab der Westböhmischen Universität. Die Suchanwendung bauten wir 2025 von Grund auf und entwickeln sie weiter.
- seit 2025, Entwicklung der Anwendung
Frühneuzeitliche Alchemie in einer Suche
Forschende finden ein Wort im ganzen Korpus und sehen sofort, wie es im Originaldruck aussieht.
EMLAP ist ein Korpus lateinischer alchemistischer Drucke von 1500–1650, entstanden am Philosophischen Institut der Tschechischen Akademie der Wissenschaften im Projekt TOME. Transkriptionen aus Transkribus und Metadaten liefert das Institut gemeinsam mit dem CCS Lab der Westböhmischen Universität. Darauf haben wir die Webanwendung von Grund auf gebaut – Import der Transkriptionen, Suche, Katalog und Seitenbetrachter.
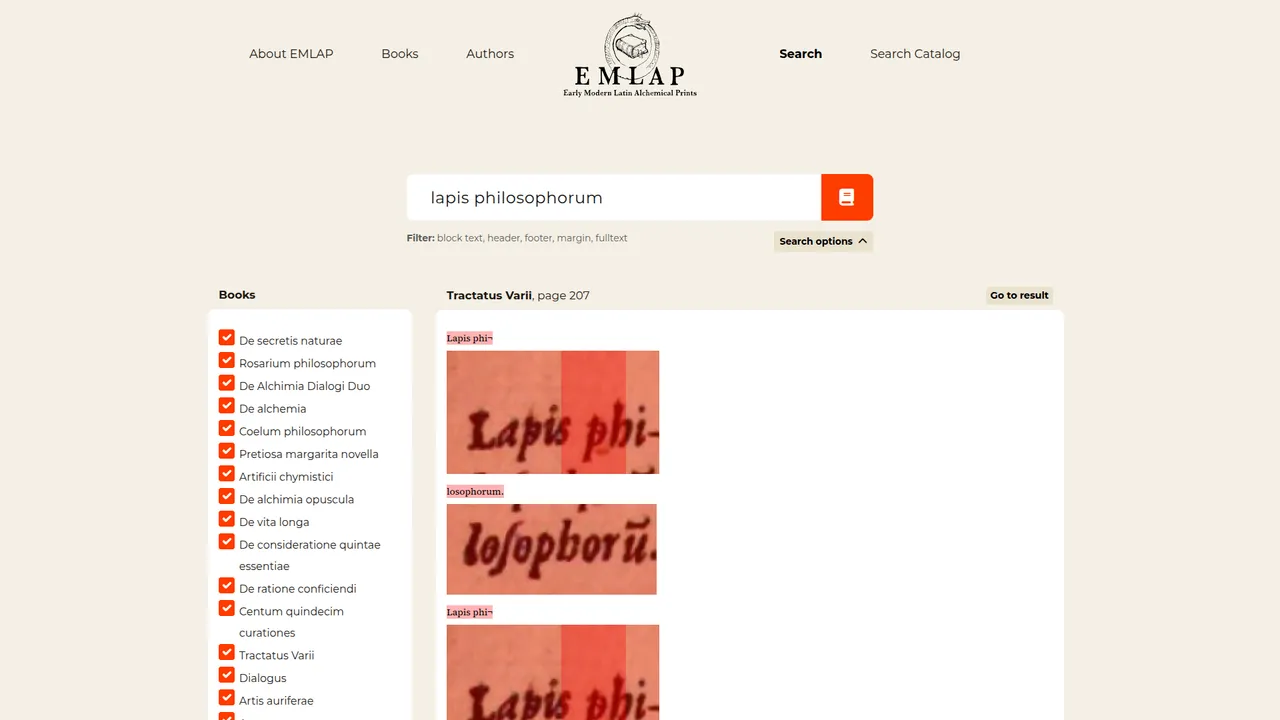
Die Suche geht durch den Text aller Seiten und dabei getrennt durch Haupttext, Kopfzeile, Fußzeile und Randnotizen – Forschende wählen, wo sie suchen. Sie findet eine exakte Phrase, einen Wortanfang oder ähnliche Formen, und die Ergebnisse lassen sich auf ausgewählte Bücher eingrenzen. Jeder Treffer zeigt einen Ausschnitt des Original-Scans mit markiertem Wort.
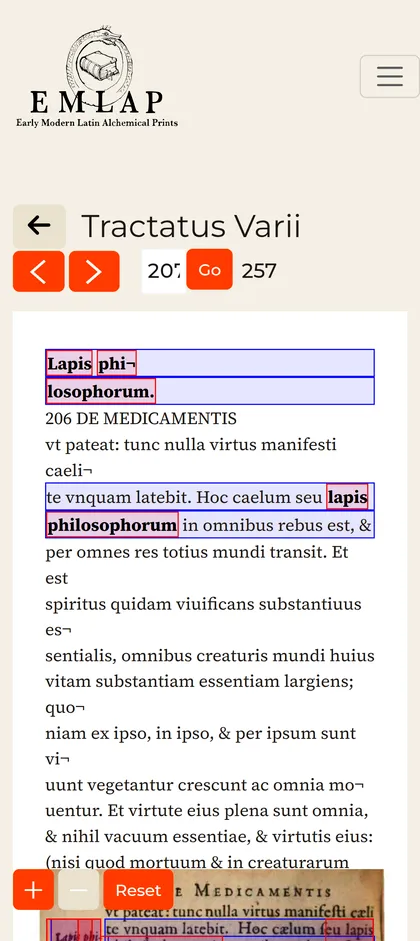
Aus dem Ergebnis öffnet sich die ganze Seite: ein zoombarer Scan, daneben die Transkription und die gefundenen Wörter in beiden markiert. Fährt man über ein Wort in der Transkription, zeigt sich seine Stelle im Scan und umgekehrt. Neben der Volltextsuche gibt es einen Katalog der Drucke mit Autoren, Verlegern, Orten und Erscheinungsjahren und eine Auswahl nach diesen Angaben.
- 100
- alchemistische Drucke im Korpus
- 1500–1650
- Erscheinungsjahre der Drucke
- 4
- Seitenbereiche, einzeln durchsuchbar
- 40+
- Autoren im Katalog
Von der Druckseite zum gefundenen Wort
Das Institut transkribiert jeden Druck in Transkribus, wo jede Zeile und jedes Wort Koordinaten im Scan erhält. Die Anwendung importiert die Transkription, verbindet getrennte Wörter und legt den Seitentext nach Bereichen im Suchindex ab. Ein Treffer erscheint dann als Ausschnitt des Original-Scans mit markiertem Wort.
Sechs Bereiche, auf denen die Suche aufbaut
Vom Import der Transkriptionen bis zur Seite, auf der Forschende ihren Treffer sehen.
-
Volltext im ganzen Korpus
Exakte Phrase, Wortanfang oder ähnliche Formen. Die Suche lässt sich auf ausgewählte Bücher und auf einen Seitenbereich eingrenzen – Haupttext, Kopfzeile, Fußzeile oder Rand.
-
Seitenbetrachter
Ein zoombarer Scan mit einer Ebene aus Zeilen und Wörtern, daneben die Transkription. Gefundene Wörter sind in beiden markiert, und das Überfahren eines Wortes zeigt sein Gegenstück.
-
Import aus Transkribus
Transkriptionen im ALTO-Format werden seitenweise in Zeilen und Wörter mit Koordinaten geladen. Anhand der in den Daten markierten Bereiche landen die Wörter im Haupttext, in Kopf- oder Fußzeile oder am Rand.
-
Buch, Seite, Zeile, Wort
Das Korpus ist bis auf einzelne Wörter und ihre Position im Scan gespeichert. Deshalb lässt sich ein Treffer im Originaldruck zeigen, nicht nur im transkribierten Text.
-
Katalog der Drucke
Angaben zu jedem Buch: Autoren, Herausgeber, Verleger, Ort und Jahr des Erscheinens, Gattungen und Themen, Links zu VIAF und Noscemus und der Download des ganzen Buchs als PDF.
-
Auswahl nach Katalogangaben
Drucke lassen sich nach Autor, Herausgeber, Verleger, Ort, Jahr und Thema auswählen. Werte, die mit der bisherigen Auswahl kein Buch ergäben, werden ausgegraut.
Wie das Projekt heute läuft
Auf den Servern des Instituts
Die Anwendung läuft auf den Servern des Philosophischen Instituts. Neue Versionen spielen wir selbst ein und betreiben bei uns eine Entwicklungsversion, auf der wir Neues testen, bevor es die Forschenden erreicht.
Suche nach Lemmata in Vorbereitung
Wir entwickeln die Anwendung weiter. In Vorbereitung sind ein Massenimport ganzer Bücher und die Suche nach Lemmata – den Grundformen aus den Daten des CCS Lab –, die auch die übrigen Formen eines Wortes findet.
Suchen Sie einen verlässlichen Partner?
Melden Sie sich unverbindlich – ein paar Sätze dazu, worum es geht, genügen, und Sie erfahren, ob wir helfen können, was die Umsetzung kosten könnte und was für den Start nötig ist.