
EMLAP
EMLAP (Early Modern Latin Alchemical Prints) je digitální korpus latinských alchymistických tisků Filosofického ústavu AV ČR. Data dodává ústav a CCS lab Západočeské univerzity. Webovou aplikaci, která v nich hledá a nález ukáže přímo na skenu, jsme v roce 2025 postavili od nuly a dál ji rozvíjíme.
- od 2025, vývoj aplikace nad korpusem
Alchymie raného novověku na jeden dotaz
Badatel najde slovo v celém korpusu a hned vidí, jak vypadá v původním tisku.
EMLAP je korpus latinských alchymistických tisků z let 1500–1650, který vznikl ve Filosofickém ústavu AV ČR v projektu TOME. Přepisy z Transkribu a metadata dodává ústav spolu s CCS lab Západočeské univerzity. My jsme nad nimi od nuly postavili webovou aplikaci – import přepisů, vyhledávání, katalog i prohlížeč stran.
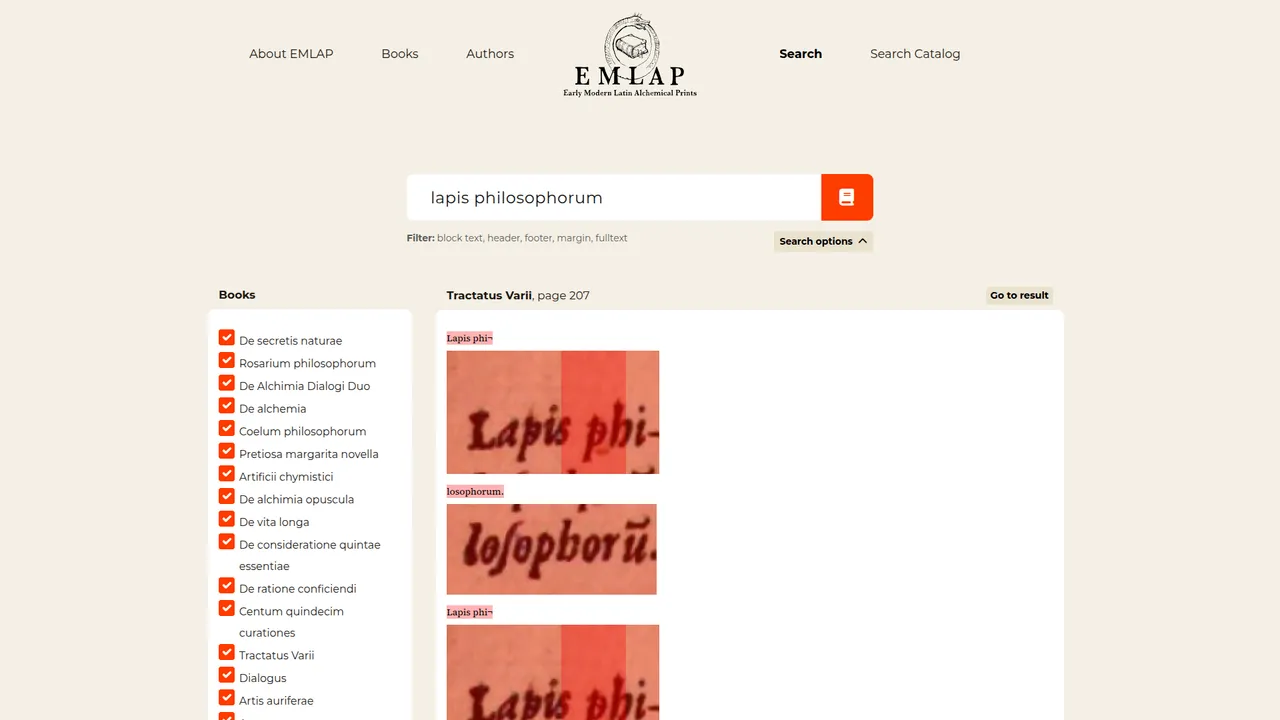
Vyhledávání prochází text všech stran, a přitom zvlášť hlavní text, záhlaví, zápatí a poznámky na okraji – badatel si vybere, kde hledat. Najde přesnou frázi, začátek slova i podobné tvary a výsledky jde zúžit na vybrané knihy. Každý nález ukazuje výřez původního skenu se zvýrazněným slovem.
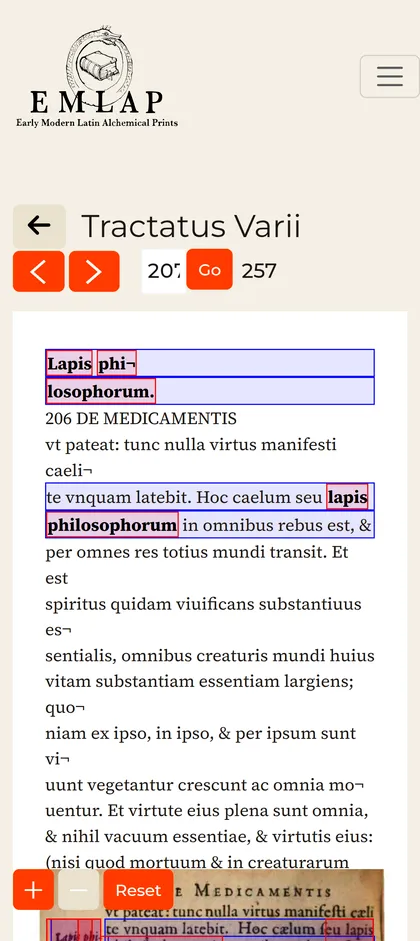
Z výsledku se otevře celá strana: přiblížitelný sken, vedle něj přepis a nalezená slova zvýrazněná na obou místech. Najetím na slovo v přepisu se ukáže jeho místo ve skenu a naopak. Vedle fulltextu je katalog tisků s autory, nakladateli, místy a roky vydání a výběr podle těchto údajů.
- 100
- alchymistických tisků v korpusu
- 1500–1650
- roky vydání tisků
- 4
- části strany prohledávatelné zvlášť
- 40+
- autorů v katalogu
Od tištěné stránky k nalezenému slovu
Ústav přepíše tisk v Transkribu, kde každý řádek a slovo dostane souřadnice na skenu. Aplikace přepis naimportuje, spojí slova dělená na konci řádku a text stran uloží do vyhledávacího indexu po částech. Nález pak ukáže jako výřez původního skenu se zvýrazněným slovem.
Šest oblastí, na kterých hledání stojí
Od importu přepisů po stranu, na které badatel nález uvidí.
-
Fulltext v celém korpusu
Přesná fráze, začátek slova nebo podobné tvary. Hledání jde zúžit na vybrané knihy i na část strany – hlavní text, záhlaví, zápatí nebo okraj.
-
Prohlížeč strany
Přiblížitelný sken s vrstvou řádků a slov a vedle něj přepis. Nalezená slova jsou zvýrazněná v obou a najetí na slovo ukáže jeho protějšek.
-
Import z Transkribu
Přepisy ve formátu ALTO se načítají po stranách na řádky a slova se souřadnicemi. Podle oblastí vyznačených v datech se slova zařadí do hlavního textu, záhlaví, zápatí nebo na okraj.
-
Kniha, strana, řádek, slovo
Korpus je uložený až na úroveň jednotlivých slov a jejich polohy na skenu. Proto jde nález ukázat v původním tisku, ne jen v přepsaném textu.
-
Katalog tisků
Údaje o každé knize: autoři, editoři, nakladatel, místo a rok vydání, žánry a témata, odkazy do VIAF a Noscemus a stažení celé knihy v PDF.
-
Výběr podle katalogu
Tisky jde vybírat podle autora, editora, nakladatele, místa, roku a tématu. Hodnoty, které by s dosavadním výběrem nedaly žádnou knihu, zešednou.
Jak projekt běží dnes
Na serverech ústavu
Aplikace běží na serverech Filosofického ústavu. Nové verze na ně nasazujeme sami a vedle toho provozujeme u sebe vývojovou verzi, na které novinky zkoušíme, než se dostanou k badatelům.
Připravujeme hledání podle lemmat
Na aplikaci dál pracujeme. Připravujeme hromadný import celých knih a hledání podle lemmat – základních tvarů slov z dat CCS lab ZČU, díky kterému se najdou i ostatní tvary hledaného slova.
Hledáte spolehlivého partnera?
Zkuste se nám nezávazně ozvat – stačí několik vět o tom, co řešíte, a dozvíte se, jestli vám dokážeme pomoci, kolik by realizace mohla stát a co je nutné pro začátek.