
Pokročilé vyhledávání v datech
Postavíme fulltext, filtry a našeptávač nad stovkami tisíc záznamů, s odezvou v desítkách milisekund. A tam, kde přesné slovo nestačí, i hledání podle významu.
Co v rámci služby dostanete
Devět témat, na která se ptáte nejčastěji. Rozklikněte, co vás zajímá – podrobnosti i odpovědi jsou uvnitř.
Čeština, jak ji píšou zákazníci
Skloňování, diakritika, jiné pořadí slov i překlepy.
Analyzátory ladíme na váš obsah, takže „dětské bundy“ najdou i „bunda pro děti“ a „detske bundy“.
Hledání podle významu
Najdeme i záznam, ve kterém hledané slovo vůbec není.
Vektorové vyhledávání pracuje s významem. Hodí se u dokumentů, inzerátů, poradny nebo zboží, které lidé pojmenovávají po svém.
- Potřebujeme k podobnosti AI?
- Vektorové vyhledávání používá model na převod textu na vektory a ten může běžet lokálně u vás. Nic si nevymýšlí – jen hledá.
- Funguje to i na interní dokumenty firmy?
- Ano. Kdo nezná firemní názvosloví, najde směrnici nebo smlouvu podle toho, jak problém popíše vlastními slovy – nemusí vědět, jak se dokument jmenuje.
Rychlé filtry a počty
Kombinace desítek parametrů i nad velkým katalogem.
Počty u jednotlivých hodnot se přepočítají s každým výběrem. Index i agregace stavíme tak, aby odezva zůstala v desítkách milisekund.
- Zvládne to náš objem?
- Stovky tisíc až miliony záznamů jsou běžné. Index i hardware navrhujeme podle objemu dat a počtu dotazů ve špičce.
- Jaké technologie používáte?
- Elasticsearch nebo OpenSearch pro fulltext a filtry, PostgreSQL s pgvector nebo samostatnou vektorovou databázi pro hledání podle podobnosti.
Našeptávač
Od prvních znaků nabízí to, co lidé skutečně hledají.
S tolerancí k překlepům a jen to, co je právě dostupné, takže nikoho nepošle na vyprodané zboží nebo stažený inzerát.
Řazení podle vašich pravidel
Stav, čerstvost, dostupnost i priority v pořadí výsledků.
Pravidla jsou popsaná a měníte je bez zásahu do aplikace.
Dotazy bez výsledku jako data
Ukážeme vám, co lidé hledají a nenacházejí.
Je to nejpřesnější informace o tom, co v katalogu nebo v obsahu chybí. Podle ní relevanci dál ladíme a vy víte, co doplnit.
Jak to stavíme
Na skutečných dotazech vašich uživatelů, ne na laboratorním vzorku.
-
Data a dotazy Co se hledá, čím se to hledá dnes a kde to selhává. K tomu struktura dat a jazyk obsahu.
-
Index, relevance a podobnost Fulltext s analyzátory pro češtinu, filtry s počty a vektorový index pro hledání podle významu.
-
Ladění v provozu Měříme dotazy bez výsledku a chování uživatelů a podle toho relevanci dál upravujeme.
Kolik to stojí
Cenu dáváme po rozboru dat a dotazů, které dnes nic nenajdou.
Ovlivňuje ji hlavně objem a struktura dat, počet filtrů a to, jestli je potřeba hledání podle významu. Na vzorku vašich dat ukážeme, jak by výsledky vypadaly, dřív než se rozhodnete.
Provoz a ladění
Monitoring odezvy a průběžné ladění relevance – jen pokud o ně stojíte.
Index i pravidla relevance jsou popsané a běží u vás. Prověřený open source, žádná černá skříňka a žádná licence, na kterou byste byli vázaní.
Provoz, podpora a rozvojVyhledávání, které jsme postavili
Inzeráty, katalogy, dokumenty i výukový obsah – desetitisíce až miliony záznamů.
Všechny naše reference
Škola s nadhledem
Online procvičování učiva od základní po střední školu – přes 6 600 cvičení pro tisíce žáků a učitelů.
- 6 600+
- online cvičení
- ZŠ + SŠ
- rozsah učiva
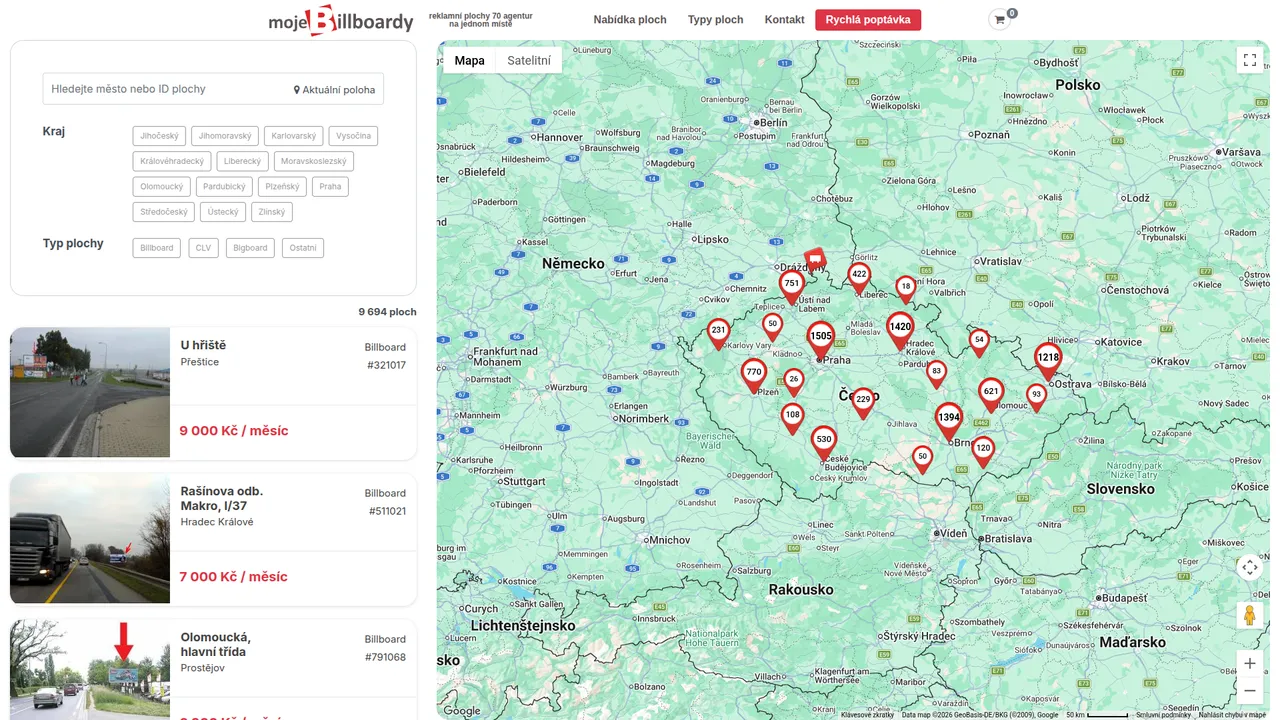
MojeBillboardy
Reklamní plochy agentur z celé republiky na jedné mapě. Zájemce zadá poptávku zdarma, agentury si kontakt odkryjí za kredit. Portál jsme postavili od nuly a vyvíjíme ho od roku 2011.
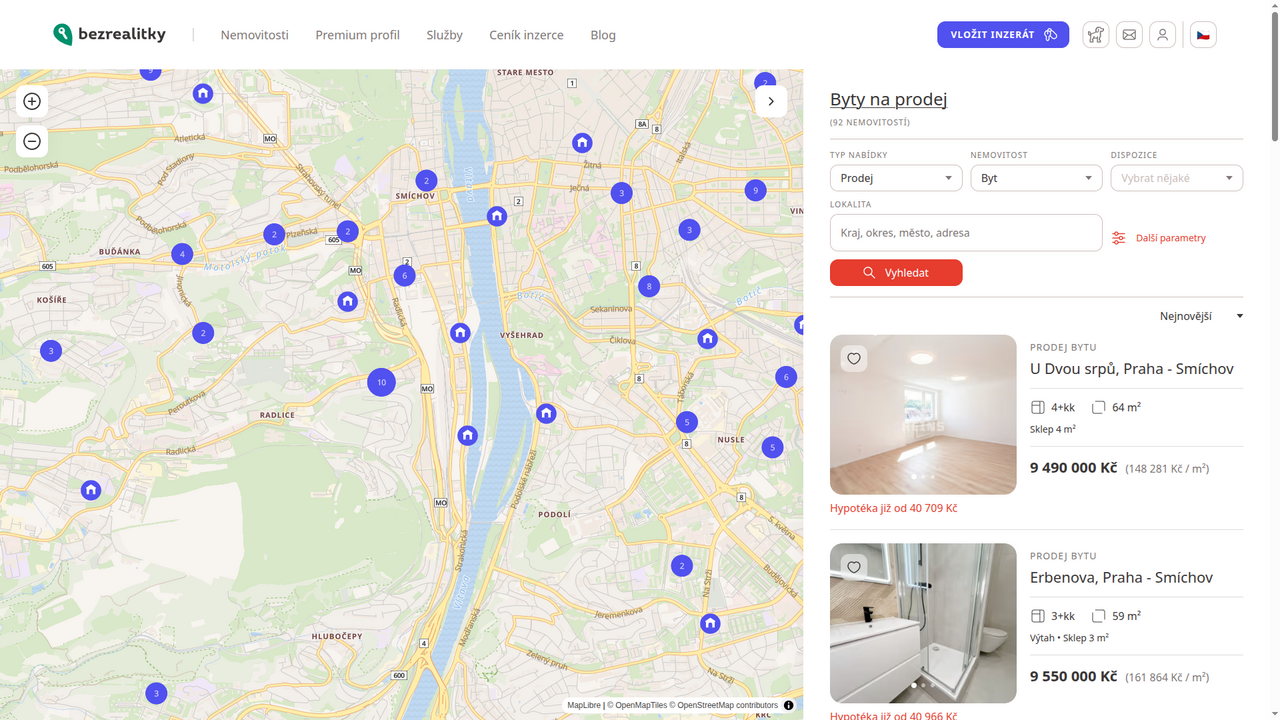
Bezrealitky
Nejúspěšnější realitní portál pro prodej a pronájem nemovitostí přímo od majitelů. Vyvíjíme ho nepřetržitě od roku 2007 a držíme v provozu při zátěži desítek tisíc lidí denně.
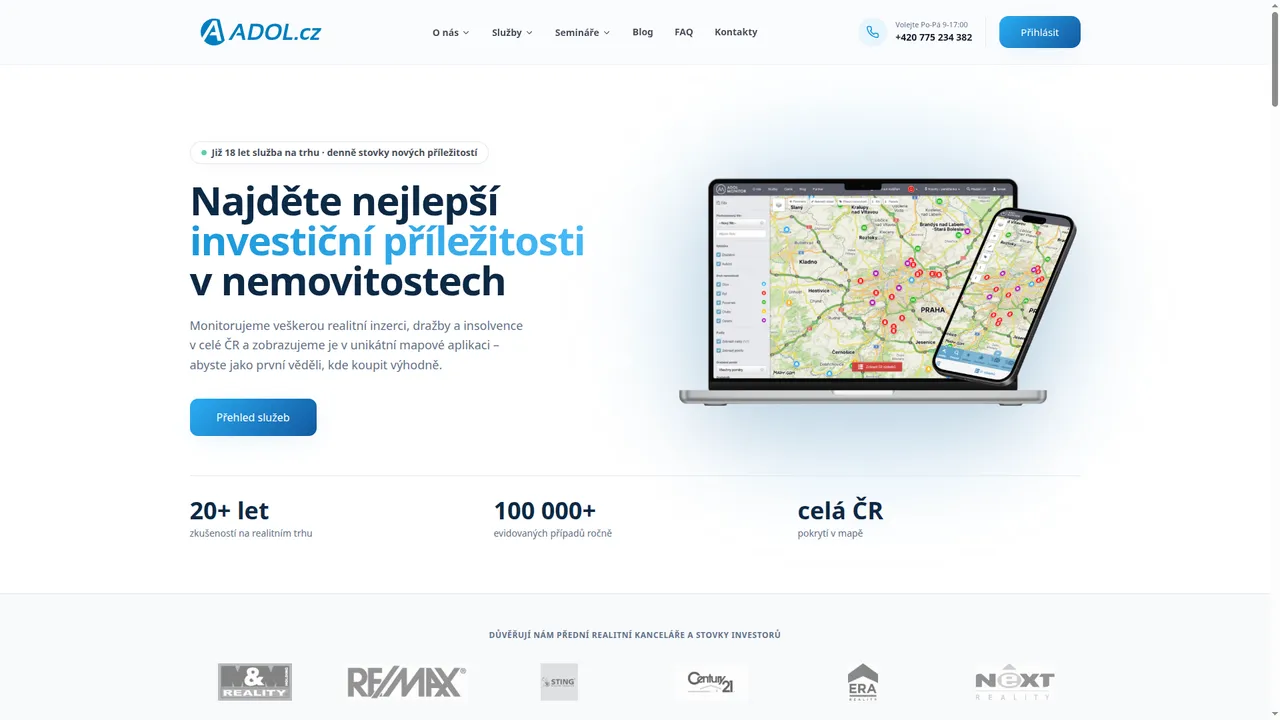
Adol Monitor
Monitoring dražeb a exekučních prodejů nemovitostí – automatický sběr dat z desítek zdrojů, jejich sjednocení a hlídací pes pro klienty.
-
CK Intertrans
Web cestovní kanceláře s rezervačním systémem a napojením na její interní systém. Z doplňku tištěného katalogu se stal hlavní prodejní kanál.
- Weby
- Vyhledávání
-
Grainterminal
Platforma pro obchod se zemědělskými komoditami – ceny spočítané z burzy a podkladů obchodníků, párování protistran na mapě a obchod až po fakturu. Dnes je součástí CleverFarm a její obchodní modul spravujeme dál.
- Portály
- Interní systémy
- Vyhledávání
- Zpracování dat
- Mapy
Proč to dát nám
Vyhledávání stavíme nad daty, která sami provozujeme. Ladí se na skutečných dotazech, ne na vzorku.
- Fulltext nad inzeráty, katalogy i výukovým obsahem máme v provozu roky – Bezrealitky, Adol Monitor, Škola s nadhledem nebo Intertrans.
- O výsledku nerozhoduje volba databáze, ale analyzátory pro češtinu, pravidla relevance a to, jak se index udržuje aktuální.
- Index i pravidla relevance jsou popsané a běží u vás, takže nejste vázaní licencí ani černou skříňkou.
Zkusíme vyhledávání na vašich datech
Pošlete nám vzorek dat a pár dotazů, které dnes nic nenajdou.